A infraestrutura de IA começa muito antes do modelo
Grandes aplicações de inteligência artificial exigem mais do que GPUs de alto desempenho. A eficiência do ambiente depende da integração entre computação, memória, rede, armazenamento e infraestrutura física.
Na SCHERM, projetamos arquiteturas orientadas ao workload, considerando desde o processamento do modelo até os requisitos de energia, refrigeração e operação em escala.
Computação acelerada
GPU, HBM e processamento massivamente paralelo.
Interconexão avançada
NVLink, NVSwitch e comunicação entre aceleradores.
Infraestrutura em escala
Alta densidade, redes, energia e refrigeração.
Da arquitetura de GPU à AI Factory
Conheça as tecnologias e decisões de engenharia que sustentam inteligência artificial em grande escala.
01 GPU Computing NVIDIA Vera Rubin NVL72 & NVIDIA HGX
O motor do paralelismo massivo
A Inteligência Artificial moderna não é limitada por ideias, mas pela capacidade de processamento matemático simultâneo e vazão de memória. Na SCHERM, projetamos infraestruturas onde a GPU é o coração de ecossistemas computacionais altamente integrados.
Além das especificações
Analisamos os requisitos de modelos como Transformers, CNNs, GNNs, LLMs e Mixture-of-Experts para definir a arquitetura ideal, considerando Tensor Cores e memórias HBM de alta largura de banda.
NVIDIA Vera Rubin NVL72
Projetamos arquiteturas baseadas no NVIDIA Vera Rubin NVL72, integrando 72 GPUs Rubin e 36 CPUs Vera em um domínio NVLink de alta velocidade, preparado para treinamento e inferência de modelos de grande escala.
NVIDIA HGX
Integramos plataformas NVIDIA HGX, com oito GPUs de alto desempenho por nó em configurações compatíveis, dimensionando servidores, alimentação, refrigeração e expansão para clusters com múltiplos nós.
Topologia otimizada
Projetamos os caminhos de dados entre GPUs, SSDs NVMe e adaptadores de rede, utilizando tecnologias como PCIe, NVLink e GPUDirect RDMA para reduzir gargalos e melhorar a eficiência computacional.

02 NVLink & NVSwitch Comunicação GPU-to-GPU em escala
Quebrando a barreira da memória
Modelos de Linguagem de Grande Escala (LLMs) podem possuir bilhões ou trilhões de parâmetros e exigir mais memória do que uma única GPU oferece. É nesse cenário que tecnologias como NVLink, NVSwitch e redes InfiniBand otimizadas fazem a diferença.
A rodovia GPU-to-GPU
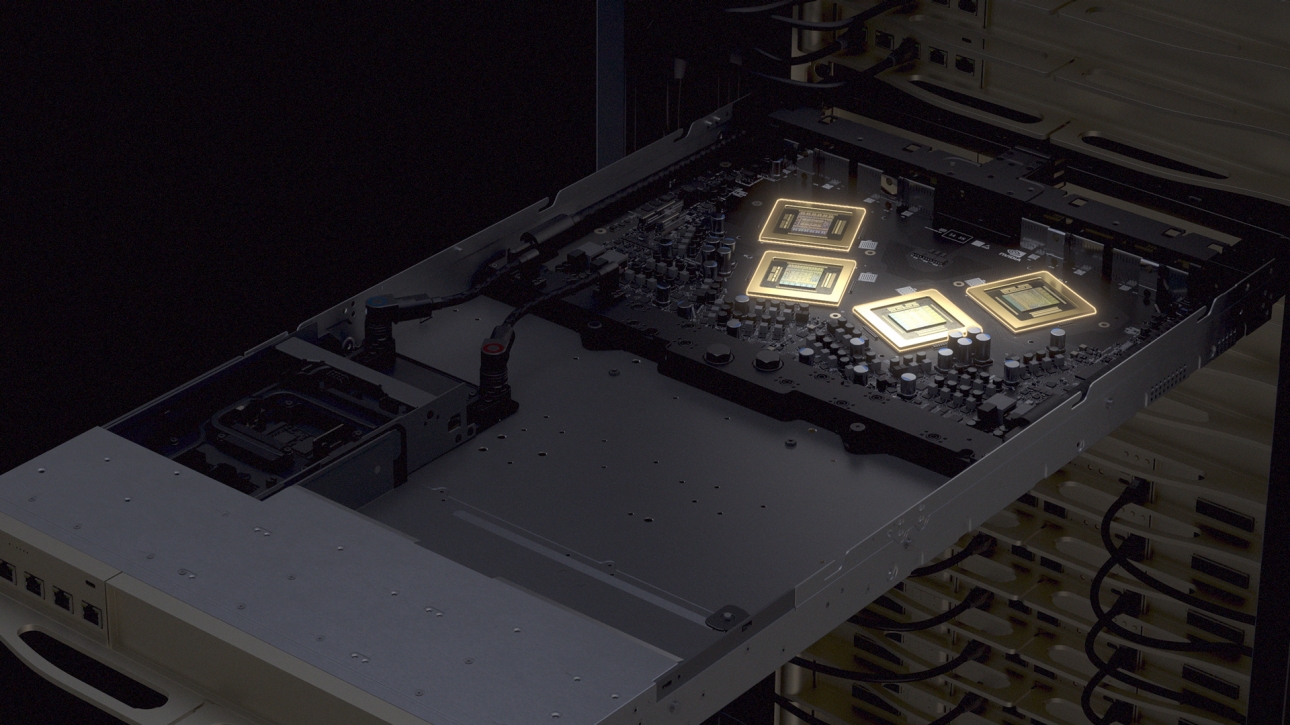
O barramento PCIe pode limitar a comunicação entre GPUs em determinados workloads. Projetamos sistemas com NVLink e NVSwitch para proporcionar largura de banda elevada e baixa latência entre aceleradores.
Uma única GPU gigante
Com uma topologia de comunicação de alto desempenho, distribuímos modelos entre as GPUs de um nó HGX, permitindo trabalhar com centenas de gigabytes de memória agregada, conforme a geração e a configuração.
O resultado
A comunicação de alta velocidade reduz o custo do paralelismo e viabiliza o treinamento de modelos que não caberiam na memória de uma única GPU.
03 Treinamento vs. Inferência Arquiteturas para desafios distintos
Arquiteturas para desafios distintos
Construir um modelo do zero exige uma infraestrutura com prioridades diferentes das necessárias para colocá-lo em produção. A SCHERM desenha clusters sob medida para cada etapa do ciclo de vida da sua IA.
A engenharia do treinamento
Scale-Up & Scale-OutTreinar um modelo pode significar processar grandes volumes de dados repetidas vezes (epochs) por semanas ou meses.
Desenhamos clusters de treinamento de alta densidade, maximizando a capacidade de comunicação inter-nós (InfiniBand/RoCE) e o acesso ao armazenamento paralelo para reduzir a ociosidade das GPUs.
A engenharia da inferência
Scale-Out e baixa latênciaQuando o modelo está pronto e os usuários começam a interagir com ele, as prioridades mudam. O objetivo passa a ser baixa latência, alto throughput e eficiência energética, incluindo métricas como tokens por segundo por watt.
Projetamos arquiteturas com GPUs otimizadas para inferência, balanceamento inteligente de carga e servidores densos para atender à demanda e expandir horizontalmente quando necessário.
04 AI Factories Data centers nativos de IA
O data center nativo de inteligência artificial
As arquiteturas tradicionais de data center nem sempre atendem às demandas da IA generativa. A SCHERM não entrega apenas servidores: projetamos a integração entre computação, redes e infraestrutura física para construir fábricas de IA.
Redes segregadas: Frontend vs. Backend
Em uma AI Factory, projetamos redes segregadas para diferentes funções. A malha backend de alta velocidade atende à comunicação distribuída entre GPUs, enquanto as redes frontend dão suporte ao acesso às aplicações e ao gerenciamento.
Quando necessário, utilizamos também redes dedicadas para armazenamento, reduzindo a disputa por banda entre diferentes tipos de tráfego.
Densidade extrema e liquid cooling
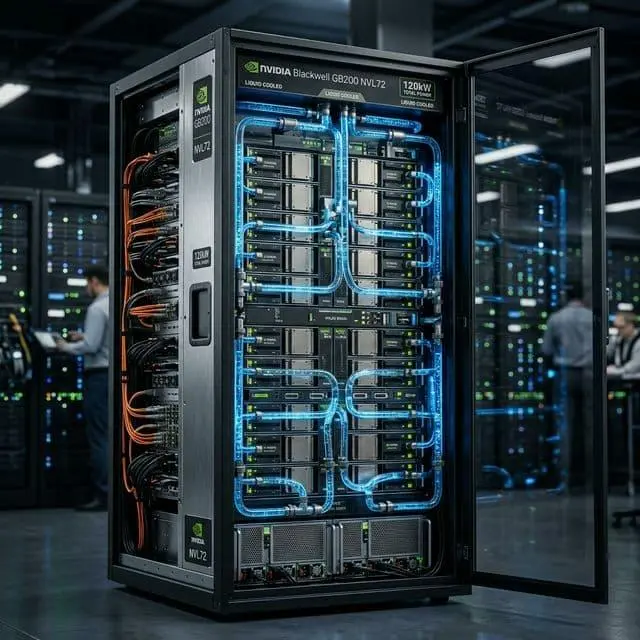
Sistemas de IA de última geração podem ultrapassar 100 kW por rack, chegando a aproximadamente 120 kW no NVIDIA GB200 NVL72 e até 142 kW no GB300 NVL72, conforme a configuração.
Projetamos a infraestrutura física, elétrica e térmica necessária para essas densidades, incluindo DLC (Direct Liquid Cooling), com remoção de calor diretamente dos componentes de maior potência.
O resultado
Um ecossistema de infraestrutura turnkey, em que facility, hardware, redes e software de orquestração convergem para criar um ambiente de produção de inteligência artificial de alta performance.