Engenharia em cada camada da infraestrutura
Cinco competências integradas para transformar desafios computacionais em arquiteturas de alta performance. Explore cada especialidade.
01 Compute Nodes Arquiteturas orientadas ao workload
A matemática do seu workload define o hardware
Não existe uma arquitetura universal para HPC. Na SCHERM, analisamos o comportamento da aplicação para definir a combinação adequada de processamento, memória e paralelismo.
Engenharia de escolha
Largura de banda de memória, frequência de clock e densidade de núcleos conforme as características da aplicação.
Topologias Fat & Thin Nodes
Combinação de servidores com elevada capacidade de RAM e nós otimizados para processamento distribuído.
Eficiência computacional
Dimensionamento alinhado às necessidades do software e à utilização dos recursos.

02 Accelerators CPU, GPU, DPU e aceleração heterogênea
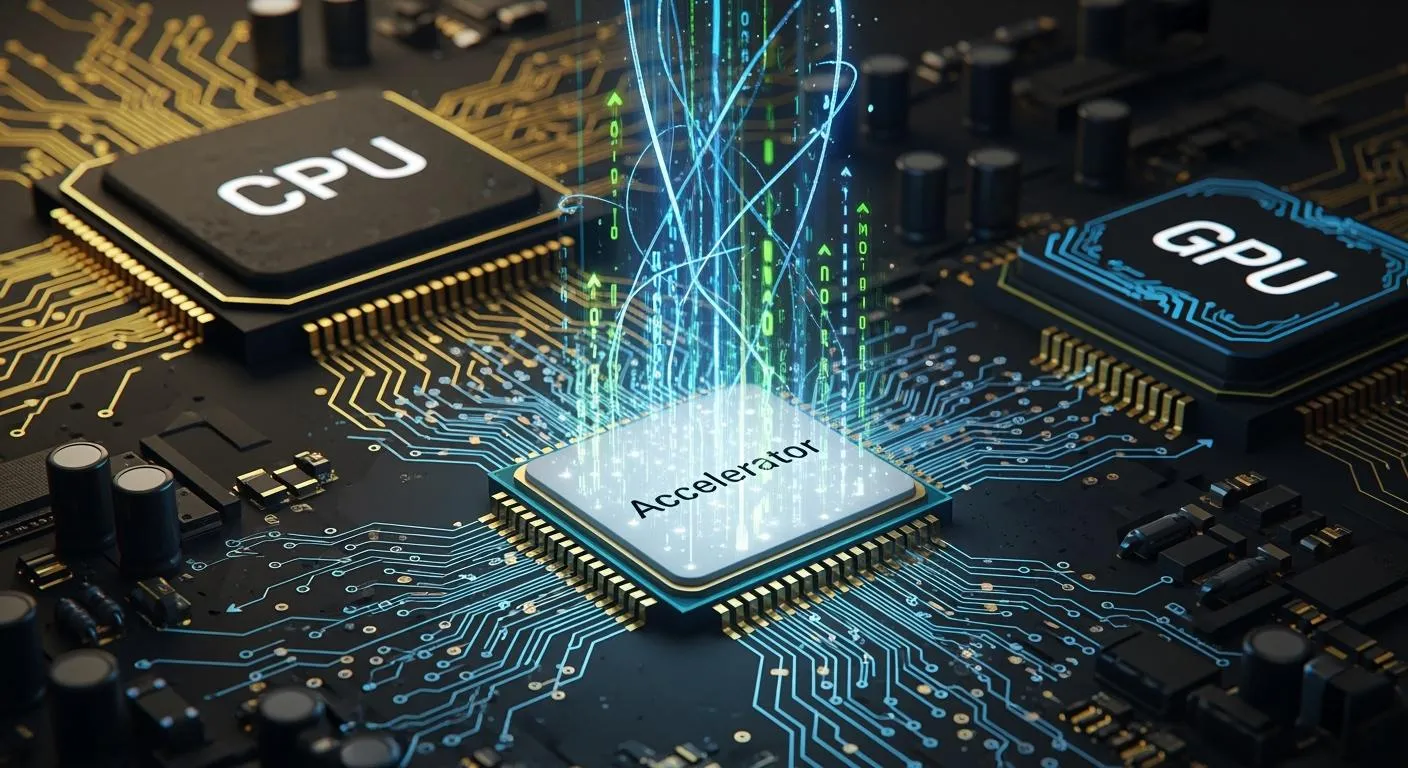
A era da aceleração heterogênea
O poder computacional moderno exige mais do que CPUs de uso geral. Projetamos infraestruturas que integram GPUs, DPUs e componentes especializados para workloads de alta exigência.
Sinergia GPU e DPU
CPUs coordenam tarefas, enquanto GPUs executam processamento massivamente paralelo.
SmartNICs e DPUs
Offloading de tarefas de rede, criptografia, segurança e movimentação de dados.
Recursos direcionados ao workload
Redução de overhead de infraestrutura e distribuição das operações entre componentes especializados.
03 InfiniBand Interconexão de baixíssima latência
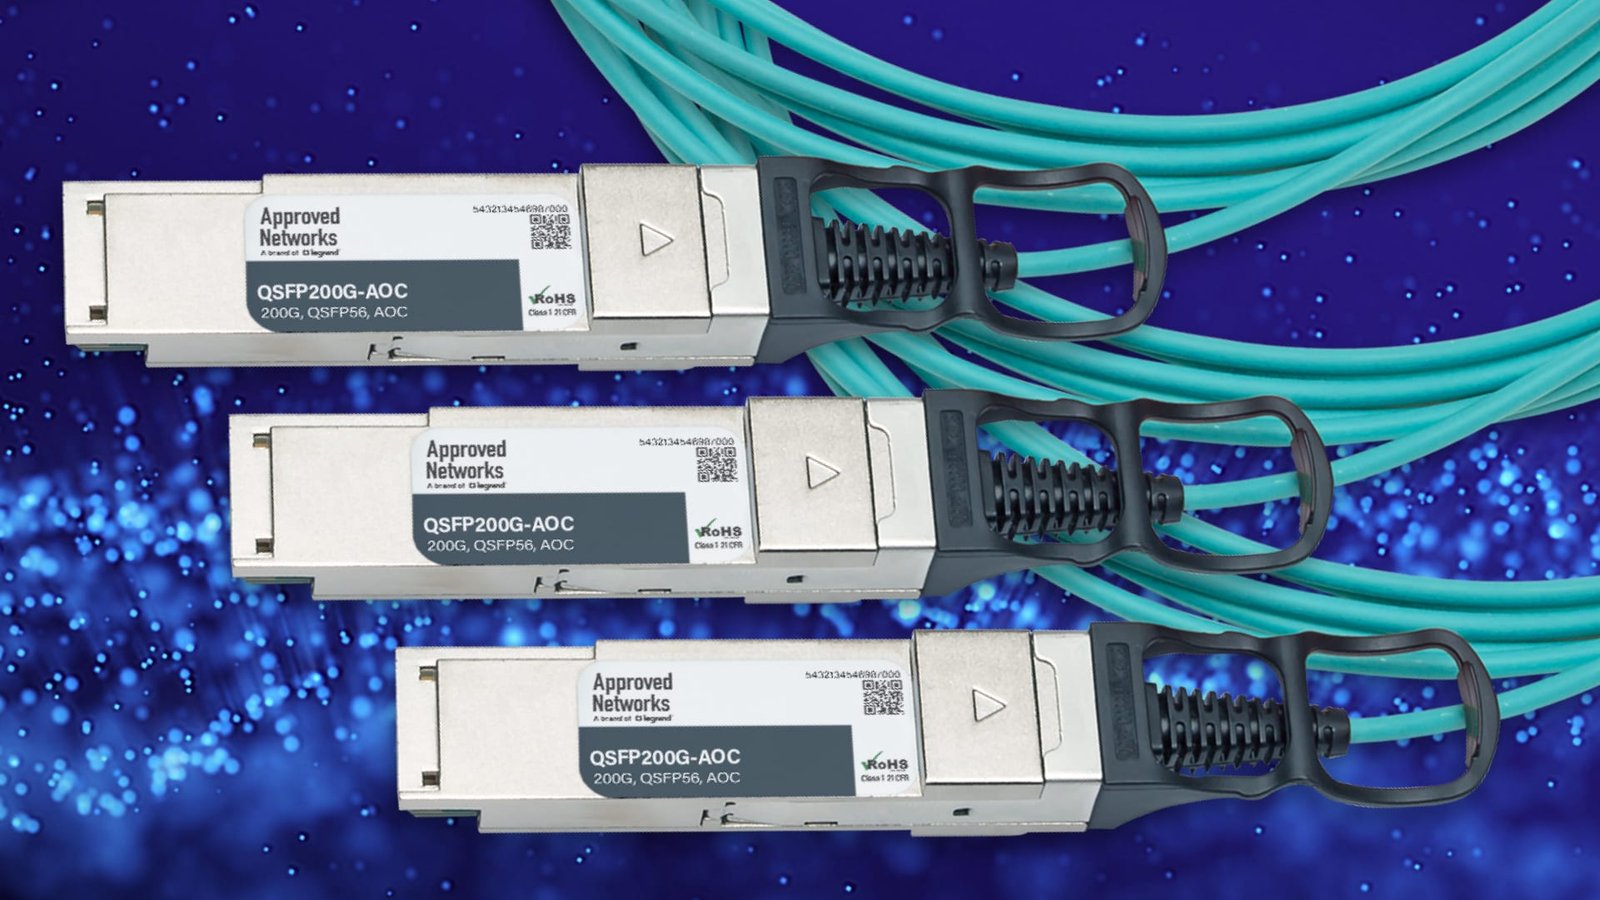
Alta velocidade e baixa latência
Na supercomputação, a rede faz parte do desempenho. Além do throughput, a latência é decisiva para workloads que dependem da comunicação constante entre milhares de núcleos.
O desafio do MPI
Trocas frequentes de mensagens exigem interconexões de baixa latência para preservar a escalabilidade.
Arquiteturas non-blocking
Topologias como Fat-Tree e DragonFly são avaliadas para reduzir contenção e gargalos de comunicação.
In-network computing
Processamento de operações coletivas na própria rede para reduzir tráfego e acelerar workloads distribuídos.
04 Parallel Storage Armazenamento paralelo e fluxo de dados
O cluster que não pode esperar pelos dados
Em HPC, processadores de alto custo não devem permanecer ociosos por gargalos de armazenamento. Projetamos sistemas paralelos para atender às exigências de acesso aos dados.
Integração sem gargalos
Lustre, BeeGFS e IBM Storage Scale integrados a tecnologias NVMe e All-Flash.
Fluxo massivo e simultâneo
Distribuição dos acessos aos dados entre múltiplos servidores e dispositivos de armazenamento.
I/O orientado à aplicação
Dimensionamento para reduzir tempos de espera e sustentar workloads intensivos em dados.
05 Cluster Management Orquestração, scheduling e observabilidade
A inteligência que orquestra a força
Um supercomputador é um ecossistema que exige inteligência operacional. Integramos provisionamento, agendamento e observabilidade para sustentar sua operação.
Provisionamento bare-metal
Automação da implantação e configuração de nós computacionais.
Schedulers HPC
Slurm e Altair PBS Professional, com políticas de filas, prioridades e alocação de recursos.
NVIDIA AI Enterprise
Integração de ferramentas e frameworks especializados para workloads de IA.
Observabilidade avançada
Telemetria de utilização, I/O, desempenho térmico e consumo energético.